For modern AI and RAG applications, achieving high search relevance requires that you combine at least two techniques: vector search for semantic context, and full-text search (FTS) for keyword precision.
For modern AI and RAG applications, achieving high search relevance requires that you combine at least two techniques: vector search for semantic context, and full-text search (FTS) for keyword precision.
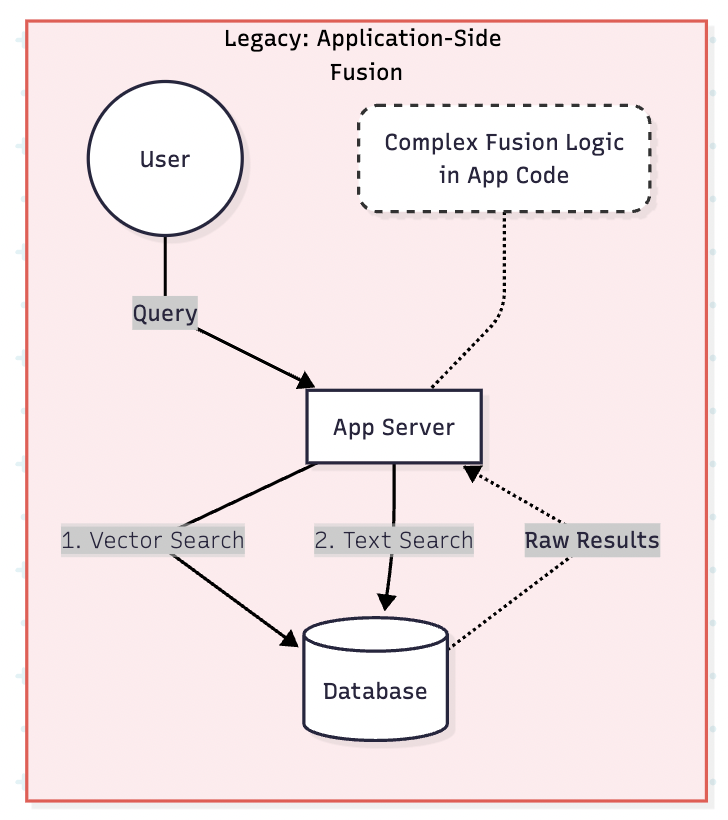
The challenge is not executing the searches, but the subsequent fusion of result sets. Merging results from the vector query (distance scores) and the FTS query (relevance scores) requires complex SQL queries or custom code in the application layer. This often means maintaining a separate system for fusion, score normalization, and re-ranking.
This article details how AlloyDB AI's hybrid search eliminates this complexity. We will explore how recent updates allow you to:
Simplify hybrid search: Consolidate complex SQL queries, or multi-step application workflows into a single, high-performance SQL function powered by Reciprocal Rank Fusion (RRF).
Optimize FTS performance: Use the new RUM extension to achieve low-latency relevance ranking and efficient phrase matching by storing word positions directly in the index.
Leverage industry-standard ranking: Utilize the new natively supported BM25 index for superior keyword-based scoring directly out of the box.
In context
- Topic: Datos y Analítica — Gobierno del dato, calidad, analítica y productos de datos.
- Source: Google Cloud Blog
- Published: 06/10/2026
Continue reading at the original source →
Excerpt published automatically by the site radar. The full text belongs to its publisher and is linked above.
Por qué importa
Lo que le da valor a los datos no es tenerlos, es que alguien cambie una decisión por ellos. Suena obvio y es la prueba que más proyectos reprueban: se construye el reporte, se publica, nadie modifica nada y a los seis meses el proyecto figura como exitoso porque se entregó a tiempo.
Yo miro el linaje antes que el gráfico: de dónde sale cada número, quién lo puede cambiar y qué pasa si el sistema origen se cae. Si nadie puede responder esa cadena en dos minutos, el tablero está mostrando confianza que no se ganó.
Lo que suele salir mal
Donde suele romperse es en la captura. Se invierte mucho en el procesamiento y nada en el punto donde la persona llena el formulario, con prisa, sin validaciones y sin saber para qué sirve. Ningún modelo arregla un dato que nació mal; solo lo propaga con más autoridad.
Qué mirar
- Quién responde por la calidad del indicador cuando alguien lo cuestiona en un comité.
- Qué decisión concreta cambia con esto y quién la toma: sin eso, es un tablero más.
- Si las definiciones están acordadas entre áreas o cada una trae la suya a la reunión.
Cómo leo esta entrada
Lo que yo pediría es un dueño de negocio por cada indicador crítico, con nombre y apellido. No un área: una persona. Los datos sin dueño se degradan solos, y cuando alguien pregunta por qué el número cambió, no hay a quién preguntarle.
La noticia original está publicada en otro idioma; acá se cita el extracto tal como lo entrega el medio y el comentario se escribe en español.
Comentarios
Todavía no hay comentarios. El primero puede ser el tuyo.
¿Lo estás viviendo en tu equipo?
Abrí el chat y contame cómo lo están manejando. Me interesa comparar notas.